ChatGPT y las IA conversacionales siguen siendo incapaces de razonar, según un estudio / Foto: Kirill Kudryavtsev - AFP/Archivos

 Óscar Puente dimite por dignidad política tras el accidente ferroviario de Urda
 CSIF reclama cambios en las cúpulas de Renfe y Adif tras la salida de Puente
 La renuncia de Puente abre a Sánchez una nueva estrategia de campaña
 RTVE estudia quién entrevistará a Feijóo durante la campaña electoral
 RomaFashion White premia la alta costura nupcial y el valor artesanal
 Forbes identifica las mayores fortunas de cada comunidad autónoma española en 2026
 Jordi Cruz explica por qué el orden del aliño cambia una ensalada
 Carmen de Burgos defendió una vida guiada por la libertad y las aspiraciones propias
 Melgarejo restó un carácter especial al duelo de Cienciano frente a Alianza Lima
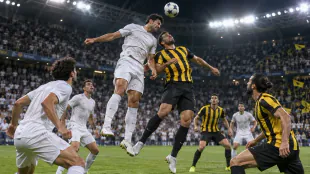 Real Madrid busca tres puntos ante el AEK en el OPAP Arena
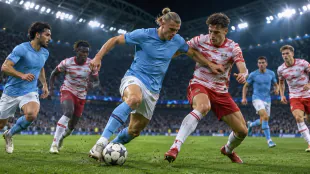 Manchester City visita al Leipzig por la cuarta jornada de la Champions League
 KKR obtiene aprobación regulatoria para invertir en Gentari Renewables India
 Disney+ estrena la segunda temporada de Todo Vale con tres episodios
 Valentino Palacios explica su polémico comentario sobre quienes madrugan para trabajar
 Giuli Cunha responde a la controversia con Ana Paula Consorte
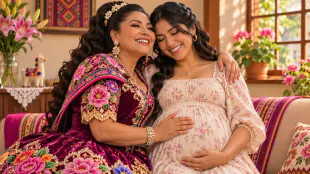 Dina Páucar anuncia que será abuela por primera vez
 Victoria mínima de Alianza Lima ante Cienciano en el Torneo Clausura
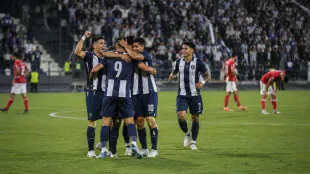 Alianza Lima venció 1-0 a Cienciano por la fecha 15 del Torneo Clausura
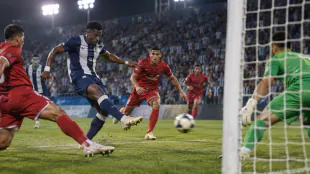
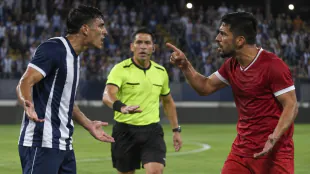 Gonzalo Aguirre discutió con Horacio Melgarejo tras ser sustituido en Matute
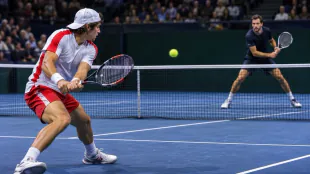 Ignacio Buse afronta ante Daniil Medvédev su gran prueba en el Masters 1000 de París
Los modelos de lenguaje de gran tamaño (LLM), como ChatGPT, uno de los sistemas de inteligencia artificial más populares del mundo, siguen teniendo dificultades para razonar usando la lógica y se equivocan con frecuencia, según un estudio.
Estos robots conversacionales reflejan los sesgos de género, éticos y morales de los humanos presentes en los textos de los que se alimenta, recuerda el estudio aparecido el miércoles en la revista Open Science de la Royal Society británica.
¿Pero reflejan también los sesgos cognitivos de los humanos en las pruebas de razonamiento?, se preguntó Olivia Macmillan-Scott, estudiante de doctorado del departamento de ciencias de computación de la University College de Londres (UCL).
El resultado de la investigación es que los LLM muestran "un razonamiento a menudo irracional, pero de una manera diferente a la de los humanos", explica la investigadora a AFP.
Bajo la dirección de Mirco Musolesi, profesor y director del Machine Intelligence Lab de UCL, Macmillan-Scott sometió siete modelos de lenguaje -dos versiones de ChatGPT (3.5 y 4) de OpenAI, Bard de Google, Claude 2 de Anthropic y tres versiones de Llama de Meta- a una serie de pruebas psicológicas pensadas para humanos.
¿Cómo afrontan, por ejemplo, el sesgo que lleva a favorecer soluciones con el mayor número de elementos, en detrimento de las que tiene una proporción adecuada?
Un ejemplo. Si tenemos una urna con nueve canicas blancas y una roja y otra urna con 92 blancas y 8 rojas, ¿cual hay que elegir para tener más posibilidades de sacar una canica roja?
La respuesta correcta es la primera urna, porque hay un 10% de posibilidades frente a solo un 8% para la segunda opción.
Las respuestas de los modelos de lenguaje fueron muy inconstantes. Algunos respondieron correctamente seis de cada diez veces la misma prueba. Otros solo dos de diez aunque la prueba no cambió.
"Obtenemos una respuesta diferente cada vez", apuntala la investigadora.
Los LLM "pueden ser muy buenos para resolver una ecuación matemática complicada pero luego te dicen que 7 más 3 son 12", afirma.
En un caso el modelo denominado Llama 2 70b se negó de manera sorprendente a responder a una pregunta alegando que el enunciado contenía "estereotipos de género dañinos".
- "No estoy muy seguro" -
Estos modelos "no fallan en estas tareas de la misma manera que falla un humano", señala el estudio.
Es lo que el profesor Musolesi llama "errores de máquina".
"Hay una forma de razonamiento lógico que es potencialmente correcta si la tomamos por etapas, pero que está mal tomada en su conjunto", apunta.
La máquina funciona con "una especie de pensamiento lineal", dice el investigador, y cita al modelo Bard (ahora llamado Gemini), capaz de realizar correctamente las distintas fases de una tarea pero que obtiene un resultado final erróneo porque no tiene visión de conjunto.
Sobre esta cuestión el profesor de informática Maxime Amblard, de la Universidad francesa de Lorena, recuerda que "los LLM, como todas las inteligencias artificiales generativas, no funcionan como los humanos".
Los humanos son "máquinas capaces de crear sentido", lo que las máquinas no saben hacer, explica a AFP.
Hay diferencias entre los distintos modelos de lenguaje y en general GPT-4, sin ser infalible, obtuvo mejores resultados que los demás.
Macmillan-Scott afirma sospechar que los modelos llamados "cerrados", es decir cuyo código operativo permanece en secreto, "incorporan otros mecanismos en segundo plano" para responder a preguntas matemáticas.
En todo caso, por el momento, es impensable confiar una decisión importante a un LLM.
Según el profesor Mosulesi, habría que entrenarlos para que respondan "No estoy muy seguro" cuando sea necesario.
M.O.Allen--AT