
La IA enfrenta el desafío de aprender a olvidar los errores asimilados / Foto: OLIVIER MORIN - AFP/Archivos

 Agenda deportiva del 3 de noviembre incluye Champions League y Liga 1
 Sedapal programa cortes de agua de hasta 15 horas en distritos de Lima
 Ana Paula Consorte reaparece tras controversia con la esposa de Hernán Barcos
 Natalia Segura es hospitalizada de emergencia por fuertes dolores
 Señalan a reportero de Magaly TV por presunto ofrecimiento de notas a cambio de encuentros
 Samahara Lobatón rechaza que su relación con Renato Rossini Jr. sea una estrategia
 Esposa de Cinesmero responde tras revelación de Jhovan Tomasevich sobre su hija
 Samsung Galaxy Tab S12 Ultra: Análisis de la tablet más ambiciosa de la marca
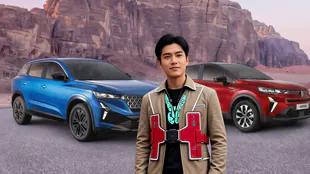 Renault lanza ediciones limitadas del Captur y el Austral por su 75 aniversario en España
 La inversión en infraestructuras de España cae a mínimos de hace 36 años
 El iceberg milenario de Alaska que el príncipe saudí trajo para salvar al mundo y terminó enfriando cócteles
 José Quispe y Rosalía Zegarra disputarán en España el título mundial de skyrunning
 Perú cierra 25 puertos por oleajes anómalos hasta el 6 de noviembre
 Alcalde de Tumbes pide apoyo nacional ante daños causados por lluvias e inundaciones
 Curibaya inaugura bungalows y muelle para impulsar el turismo en la laguna de Aricota
 José Antonio Ocampo pide ampliar el recorte de gasto en la Ley de Rescate
 Expertos alertan que cambios en aportes de salud podrían elevar evasión e informalidad
 FMI respalda el proyecto de rescate fiscal presentado por el Gobierno colombiano
 Taliana Vargas recuerda la escena de Rafael Orozco que más marcó su carrera
 Policía incauta dinero y equipos durante captura de alias Joel Piraña y Rulay
Brian Hood descubrió un día que ChatGPT le atribuía un pasado criminal, pero para resolver este error, este político australiano indagó en un problema que plantea también un desafío para los ingenieros: cómo enseñar a la Inteligencia Artificial (IA) a borrar información errónea.
Hood intentó una solución convencional y amenazó con demandar por difamación a OpenAI, la empresa creadora de ChatGPT.
Pero entrenar a este tipo de robot es un proceso lento y costoso, por lo que este problema expone a la luz un desafío que será crucial en los próximos años, especialmente de cara a la reglamentación en la Unión Europea sobre protección de los datos personales.
Hood afirma que sus comunicaciones con OpenAI no fueron de gran ayuda, pero que sus quejas, que inundaron los medios, solucionaron el problema cuando la empresa actualizó la aplicación y el robot dejó de repetir estas afirmaciones falsas sobre sus antecedentes penales.
"Irónicamente, la gran cantidad de [información en] prensa sobre mi historia corrigió los registros", relató a AFP Hood, que es alcalde de la ciudad de Hepburn, en Australia.
La empresa OpenAI no respondió a las peticiones de comentarios sobre este tema.
"La capacidad de eliminar datos de las bases de datos de entrenamiento es un tema crítico de cara al futuro", señaló Lisa Given, de la Universidad RMIT de Melbourne, en Australia.
En el caso de los buscadores de internet, es posible borrar entradas, pero este proceso no es tan simple con los modelos basados en la IA.
En respuesta a este desafío, un grupo de científicos está estudiando un nuevo campo denominado el "desaprendizaje automático", que trata de entrenar algoritmos para que "olviden" datos que sean problemáticos.
- "Una herramienta interesante" -
Un experto en este campo, Meghdad Kurmanji de la Universidad de Warwick en el Reino Unido, explicó a AFP que este tema comenzó a cobrar relevancia en los últimos tres o cuatro años.
Entre quienes se apuntaron a este desafío está Google DeepMind, la división de IA del gigante californiano.
Los expertos de Google redactaron junto a Kurmanji un artículo publicado el mes pasado en el que proponen un algoritmo para depurar los datos seleccionados de las bases que componen los algoritmos en los que se basan ChatGPT y el chatbot Bard de Google.
Además, Google lanzó una competencia en junio para medir distintos métodos para "desaprender", que hasta ahora atrajo a más de 1.000 participantes.
Kurmanji afirma que "desaprender" puede ser una "herramienta muy interesante" para que los motores de búsqueda administren las peticiones para eliminar contenido, por ejemplo debido a asuntos relacionados con las leyes sobre la privacidad.
El experto afirmó además que el algoritmo también logró buenos resultados en pruebas de eliminación de material protegido por derechos de autor y en la corrección de sesgos.
- "No es la panacea" -
Lisa Given señaló que todavía hay mucho desconocimiento sobre cómo funcionan estos sistemas e incluso sobre cuáles son las bases de datos que sirven como entrenamiento para estas máquinas, por lo que encontrar una solución puede ser un proceso largo.
Michael Rovatsos, de la Universidad de Edimburgo, apuntó que quedan aristas técnicas por resolver, por ejemplo qué hacer si una compañía recibe una ola de peticiones para eliminar contenido.
Añadió que el desaprendizaje no resuelve temas más amplios que enfrenta la industria de la IA, como la forma en que la que se recopilan los datos, quién se beneficia de su uso o quién asume la responsabilidad si un algoritmo causa un daño.
"La solución técnica no es la panacea", afirmó.
En un momento en que la investigación sobre este campo está en pañales y la regulación es casi inexistente, Hood, que es un ferviente defensor del la IA, pese a su experiencia, señaló que todavía estamos en una era de soluciones anticuadas.
"Cuando los chatbot generan basura, los usuarios simplemente necesitan revisar todo dos veces", afirmó.
Ch.P.Lewis--AT